Jevで試す、言葉で動かすデータ可視化 — ダッシュボードはどう変わるか
見たいことを言葉にすると、データの表示が変わる。判断に特化した新しいモデル「Jev」を使い、個人の試作として、交通量の可視化を音声や文章で操作するトライアルを行いました。決まった操作の型と言葉の解釈を組み合わせることで、データ探索に必要な習熟や、ダッシュボード・プレゼンテーションの設計がどう変わるかを考えます。
「時間の推移を見せて」「大型車だけ」「関東と九州」。見たい内容を言葉で伝えると、地図やグラフが切り替わる。新しいAIモデル「Jev」を使い、交通量データの可視化を操作するプロトタイプを個人で制作しました。今回試したのは、見たいことを思いついてから、そのデータを画面で確かめるまでを、どこまで短くできるかということです。
Jevは、ソフトウェアが使う判断を返すモデル
Jevは、TypeSafe AIが2026年9月15日に発表した「System One Model」です。自然言語で書かれた状況を読み、あらかじめ定義した選択肢や評価尺度に沿って判断を返します。System Oneという名前は、素早く直感的な思考を指す「システム1」に由来します。ソフトウェアの中で、小さく区切った判断を素早く行うことを目指したモデルです。
特徴は、文章の生成を行わず、プログラムが直接使える形式で答えることです。「どの表示にするか」と選択肢を渡せば、その中から一つを選んで返します。選択肢から選ぶChoice、尺度に沿って評価するScore、ある記述が正しい確率を返すNoulの三つの機能があり、今回使ったのはChoiceです。
複数の問いを一回のリクエストにまとめ、同じ入力に対して並列に判定できることも、画面操作との相性がよい特徴です。Choiceでは、選ばれた答えだけでなく、選択肢ごとの確率と確度が返ります。アプリはそれを使い、すぐに操作を反映するか、利用者に確認するかを決められます。
LLMでもできる操作を、短い待ち時間で
自然言語を画面操作に変えること自体は、LLMでも実現できます。今回Jevを使うことで、こうした小さな判断を、より低いコストと短い待ち時間で繰り返せるのではないかと考えました。表示を変えるたびにモデルを呼び出すなら、一回ごとの待ち時間と費用が、探索の続けやすさに関わります。
2026年9月27日時点の公式料金は、入力100万トークンあたり0.042米ドルで、出力への課金はありません。TypeSafeは応答速度の短さも特徴として掲げています。ただし、今回は同じ条件でLLMと速度・費用・解釈の正確さを比較したわけではありません。ここは今後検証が必要そうです。
一つの発話を、小さな判断に分ける
今回の試作では、表示方法、車種、地域、時刻、再生、色分けなどを、それぞれ独立した問いとして用意しました。たとえば「関東の大型車を地域で比べて」という指示を、表示は地域比較、車種は大型車、地域は関東という選択に対応づけます。その結果を受けて、アプリが集計と描画を行います。
「関東と九州」のような複数指定は、地域ごとに「その地域を挙げたか」を問い、答えを組み合わせて扱います。別の問いで、地域を追加するのか、除外するのか、置き換えるのかを判定します。現在選んでいる地域も入力に含め、「九州も」「九州は外して」といった続きの指示を操作につなげています。
これは、Jevが自由にグラフや操作を作る仕組みではありません。開発側が操作の型を決め、その範囲で利用者の言葉を解釈させています。音声を文字にするのはブラウザーの音声認識で、Jevが受け取るのは、その文字と現在の画面の状態です。Jev自体は現時点で音声を直接入力できません。
画面には選ばれた操作と確度を表示し、変更する項目の確度が低い場合は、適用するか取り消すかを利用者に確認します。ただし、確度は選択肢への確率の集中具合から算出する指標で、その回答が正しい確率そのものではありません。決まった形式で答えが返ることと、意図を正しく読み取れることは、分けて考える必要があります。
データを探索するための習熟を減らせるか
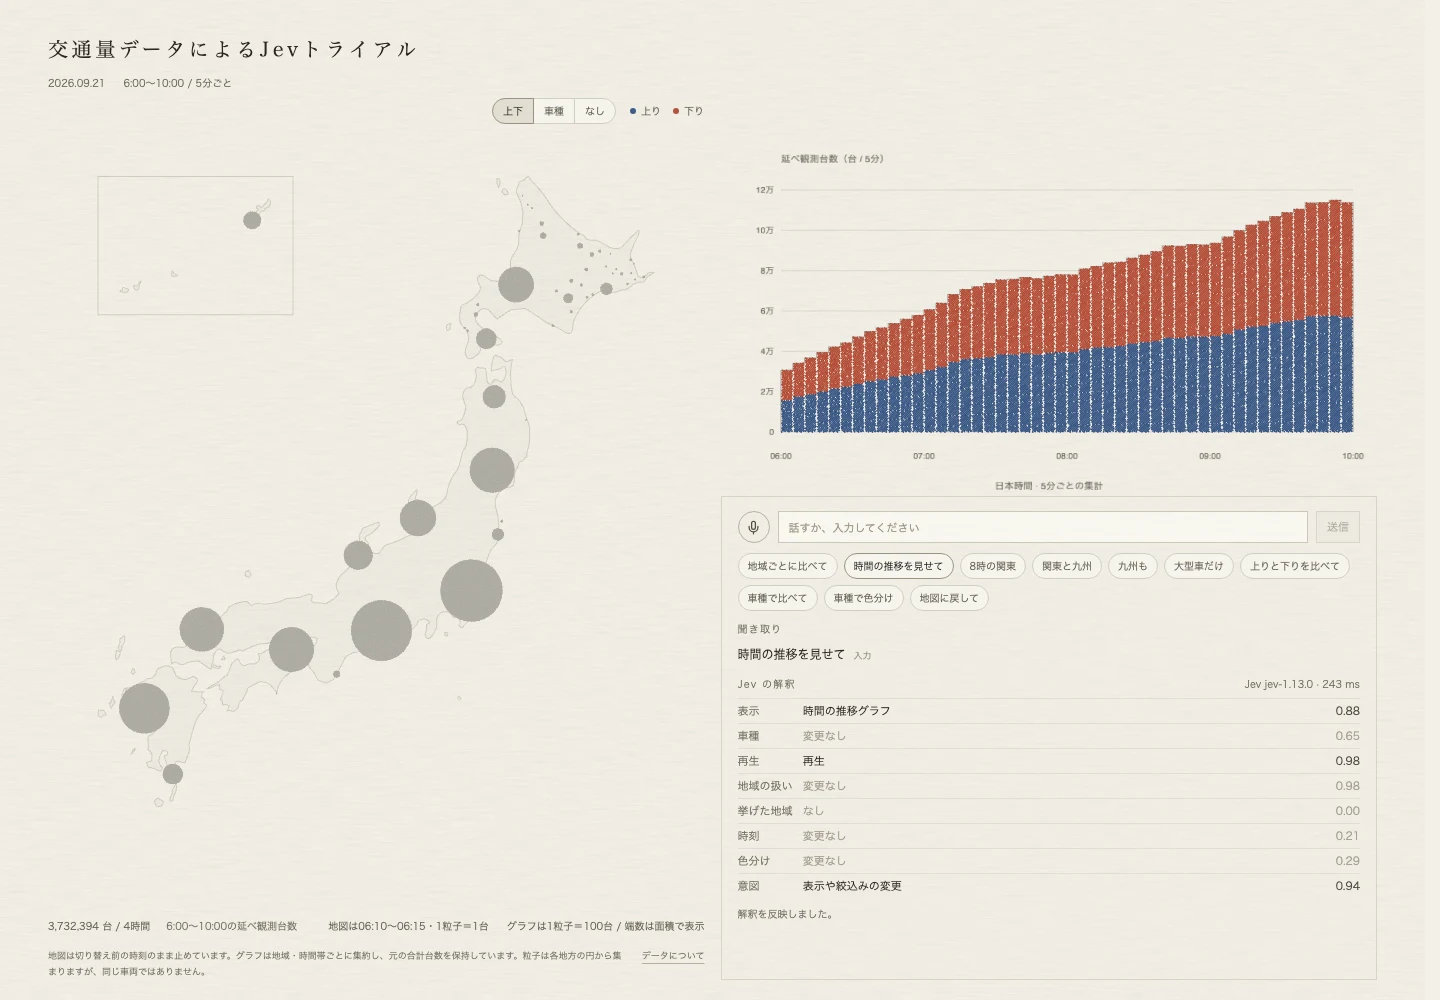
試作では、用意した型に沿って言葉を解釈し、表示を切り替える動作を確認できました。「時間の推移を見せて」という入力に対する一回の計測では、サーバーからJevへの通信と応答検証を含めて243ミリ秒でした。音声認識や画面のアニメーションは含まない値ですが、思いついた問いを、その場で次の表示につなげる使い方を試せました。
この応答をデータ探索の中で繰り返せるなら、利用者に求められる習熟は変わりそうです。従来は「大型車の地域差を見たい」と思っても、フィルターの場所やグラフの切り替え方を覚える必要がありました。言葉で指定できれば、その操作を探す手間を減らし、関心のある違いを続けて確かめられます。
ここから得た仮説は、データ探索を始めるために必要な知識や操作習熟を少なくできるのではないか、というものです。一方で、表示された比較が妥当かを判断する力は引き続き必要です。今回の交通量でも、地域ごとの観測点数の違いを、交通量そのものの違いと取り違えるおそれがあります。比較条件やデータの制約を確かめられる表示も、操作のしやすさとあわせて設計する必要があります。
今回の試作だけでは、操作の負担がどれだけ減るか、日本語の言い換えにどの程度対応できるかまでは分かりません。意図しない変更の頻度や応答時間を調べ、マウス操作との比較を行うことが、次の検証になります。
今後の活用シーン
今回試したのは用意した表示の切り替えですが、その先には、問いに応じて指標や比較対象を組み立てる、generativeなダッシュボードが考えられます。地域の担当者は自分の地域を、物流の担当者は大型車や時間帯を中心に見る。同じデータから、一人ひとりの目的に合った画面を作る方向です。
設計の対象も、グラフの配置から、使える指標・比較条件・操作の組み合わせへ広がります。利用者が操作を覚える負担を減らすほど、作り手はデータの意味と扱える範囲を明確にしておく必要があります。Jevは、その定義に沿って表示を素早く選ぶ役割を担えそうです。
こうした画面は、プレゼンテーションにも使えそうです。「その地域だけでは?」「大型車だけなら?」という聞き手の疑問を受け、その場で表示を変えて一緒に確かめる。用意した図で説明することに加え、対話しながらデータを探索する時間が生まれます。
全員が比較を追えるよう、選択中の条件を示し、前の表示に戻ったり共有したりできることも必要です。個人の問いに応じて変わる画面を、共同で考える場にどう使うか。今後もJevを使ったデータ可視化とコミュニケーションの可能性を探っていきたいと思います。
試作に使った交通量データと表現
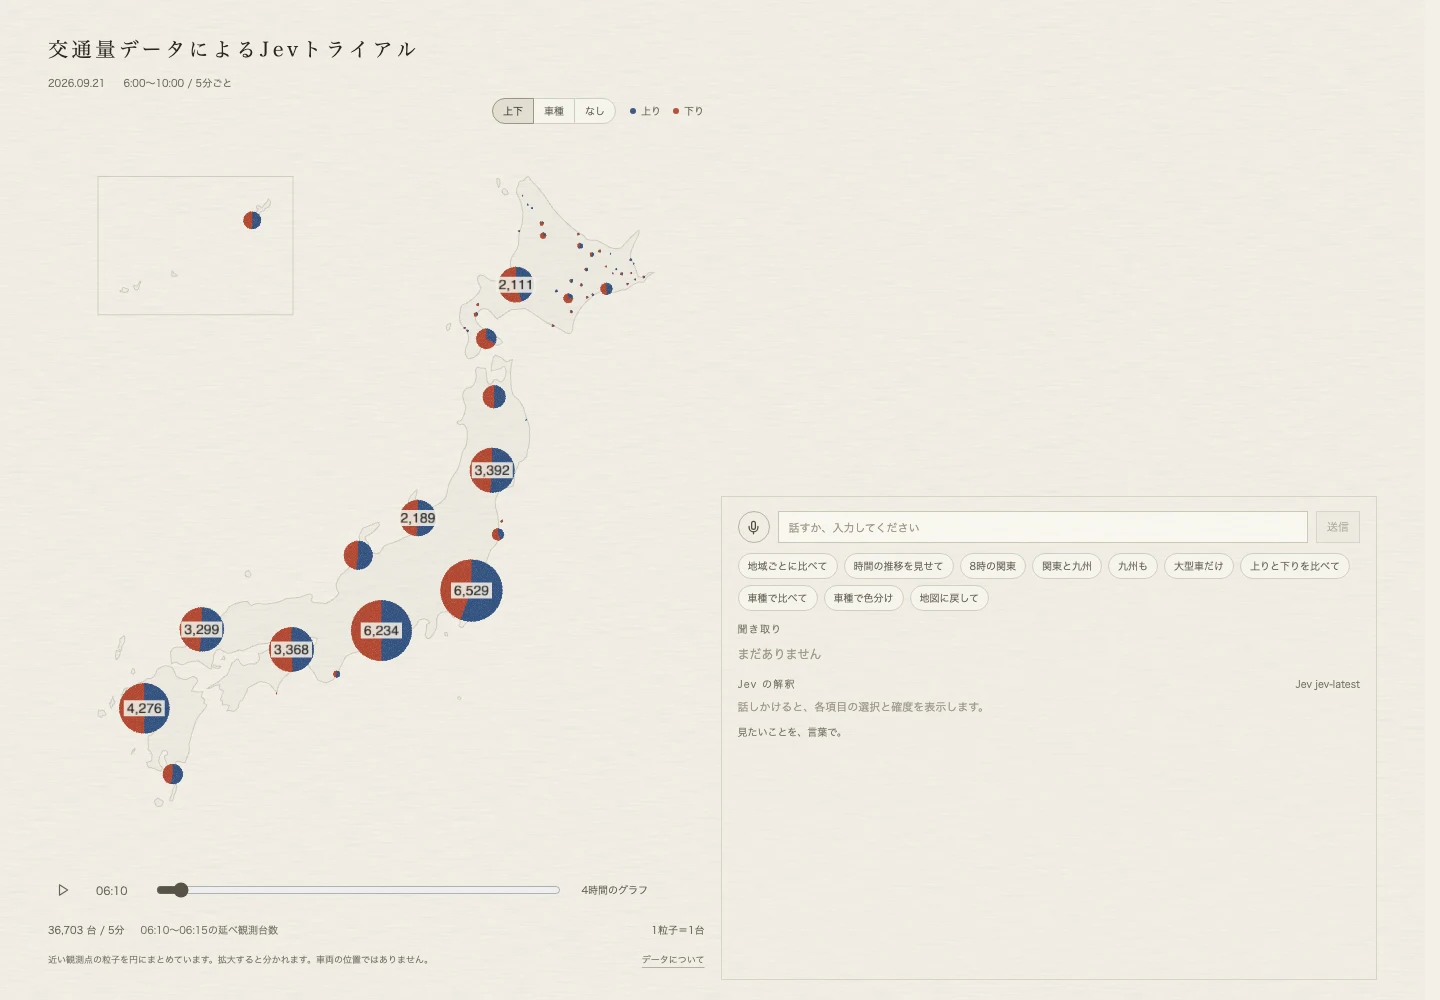
国土交通省が収集し、日本道路交通情報センター(JARTIC)が公開するデータから、2026年9月21日6〜10時の5分値が揃い、位置・品質フラグを確認できた1,137地点を採用しました。取得済みデータを再生しています。
地図は1台を1粒、4時間分のグラフは100台を1粒とし、端数は面積で表します。粒子は台数を表す記号で、車両の位置や軌跡ではありません。地図上の円も、重なりを避けるため観測点から位置をずらしています。
対象は公開された一般国道の観測点に限られ、合計は同じ車の重複を含む延べ台数です。地域間の比較は、観測点数や欠測による除外の違いにも左右されます。
※ 国土交通省API機能による交通量(参考値)を加工して作成しています。内容は国土交通省によって保証されたものではありません。
- CategoryData Visualization